1. 개요: 2026년 대형 언어 모델(LLM) 세대교체
2026년에 들어서며 AI 모델 간 성능 경쟁은 단순 파라미터 크기 싸움에서 생각하는 AI(Reasoning capability)와 실제 가성비 및 응답 속도의 싸움으로 전환되었습니다. BenchLM 종합 순위는 최신 릴리스된 모델들의 하이브리드 추론 성능과 코드 생성 능력을 실시간으로 반영하여 평가합니다.
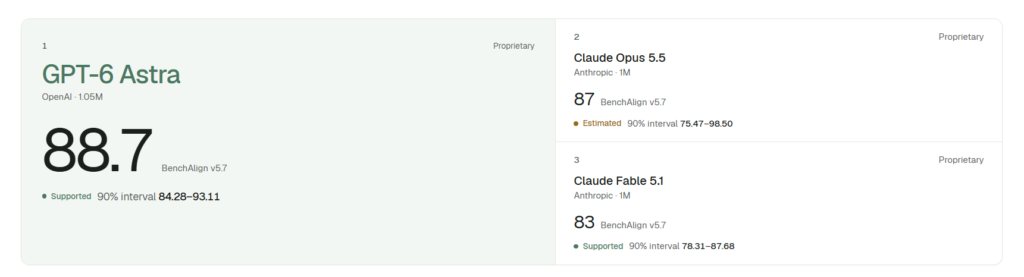
ALT Text: AI 모델 성능 지표와 알고리즘 순위가 표시되는 디지털 리더보드 인터페이스
2. BenchLM 종합 순위 상위 AI 모델 비교
BenchLM의 종합(Overall) 평가 지표를 기준으로 한 최상위 AI 모델들의 주요 사양과 강점은 다음과 같습니다.
| 순위 | 모델명 | 주요 특징 및 특화 영역 |
| 1위 | Claude 3.7 Sonnet | ‘하이브리드 추론(Hybrid Reasoning)’ 도입으로 코딩, 복잡한 명령어 이행 및 긴 문맥 이해도 1위 |
| 2위 | Gemini 2.0 Flash | 압도적인 응답 속도, 멀티모달(Vision/Audio) 처리 능력 및 실시간 API 가성비 우수 |
| 3위 | OpenAI o3-mini | 수학, 과학, 복잡한 논리적 추론 및 알고리즘 구현에 특화된 심층 추론 모델 |
| 4위 | GPT-4o (Updated) | 실시간 음성/영상 인터랙션 및 범용 텍스트 생성 분야의 안정적인 성능 유지 |
| 5위 | DeepSeek-R1 / V3 | 오픈소스 라이선스 기반의 강력한 비용 대비 추론 효율성 자랑 |
하이브리드 추론과 실시간 성능의 균형
1위를 기록한 Claude 3.7 Sonnet은 사용자가 ‘생각하는 시간(Thinking budget)’을 직접 제어할 수 있는 하이브리드 방식을 적용해, 간단한 질문에는 즉각 답변하고 고난도 코딩 및 분석 작업에는 심층적인 추론을 수행하는 유연함으로 높은 점수를 받았습니다.
반면 Gemini 2.0 Flash는 빠른 속도와 저렴한 인퍼런스 비용에도 불구하고 상위권 모델에 육박하는 고성능을 발휘하여 효율성 부문에서 압도적인 평가를 얻었습니다.
3. BenchLM 평가의 핵심 기준 및 시사점
BenchLM이 기존 벤치마크와 차별화되는 점은 실제 사용 환경과의 밀접함입니다.
- 실전 코딩 및 에이전트 능력: 개발자의 실제 리포지토리 작업(SWE-bench)과 지능형 에이전트 동작 수행 정확도 측정
- 환각(Hallucination) 감소율: 고난도 질문에 대해 잘못된 답을 사실처럼 말하는 환각 현상의 최소화 여부
- 비용 대비 성능(Cost-Efficiency): 토큰당 가격 대비 산출되는 결과물의 품질 비율 평가
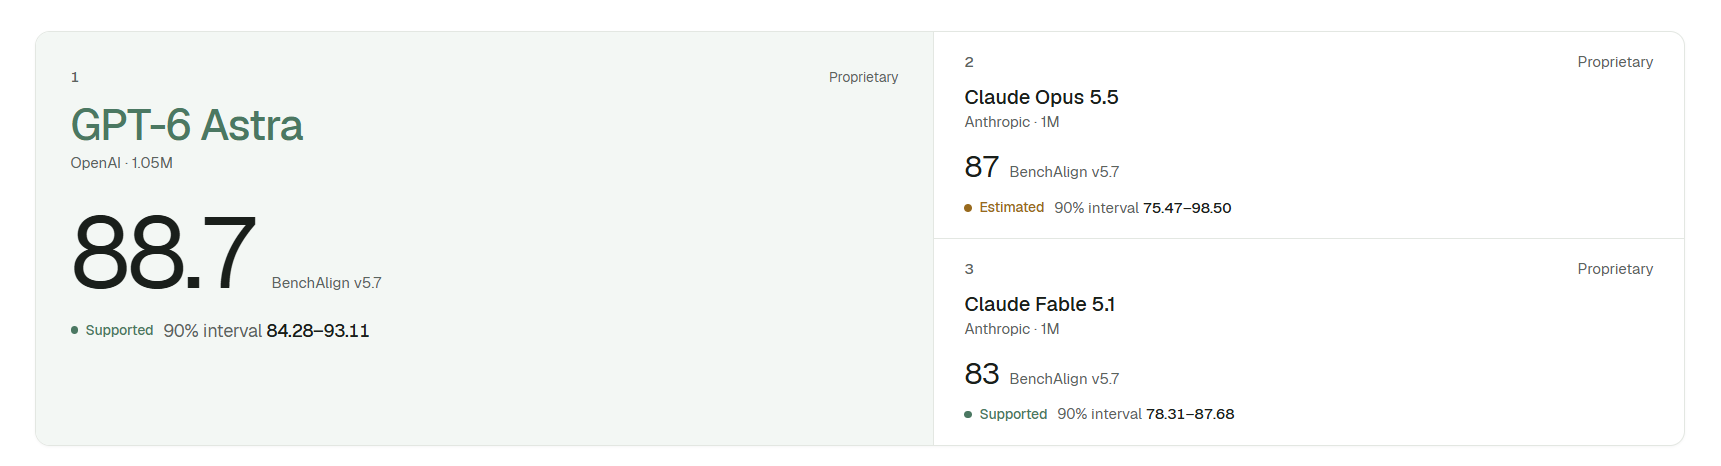
ALT Text: 다양한 AI 알고리즘 모델의 데이터 처리 속도와 추론 능력을 비교하는 그래프
4. 최종 결론 및 전망
장점 (Strengths):
- 추론 속도 및 정확도가 대폭 향상되어 전문적인 작업(프로그래밍, 학술 연구)에서의 활용성 극대화
- 오픈소스 모델(DeepSeek 등)의 급부상으로 인한 AI 모델 이용 비용의 하향 평준화
과제 (Challenges):
- 고성능 모델일수록 요구되는 데이터센터 및 전력소비량 증가 문제
- 벤치마크 오염(Data Contamination)을 방지하기 위한 지속적인 평가 기준 업데이트 필요
💡 총평
2026년 BenchLM 종합 순위는 “더 이상 절대적인 단 하나의 승자는 없다”는 점을 보여줍니다. 개발 및 복잡한 작업에는 Claude 3.7 Sonnet과 o3-mini, 실시간 서비스 구축에는 Gemini 2.0 Flash 등 사용 목적에 맞는 맞춤형 모델 선택이 더욱 중요해지고 있습니다.